Tecnologia
Inovação, startups e empreendedorismo sem complicação.
Informação para o próximo passoquinta-feira, 8 de outubro de 2026
O problema que investiga os limites dos computadores nasceu nos anos 1970. Uma solução poderia mudar a otimização e a segurança digital, mas seu efeito dependeria dos algoritmos envolvidos.
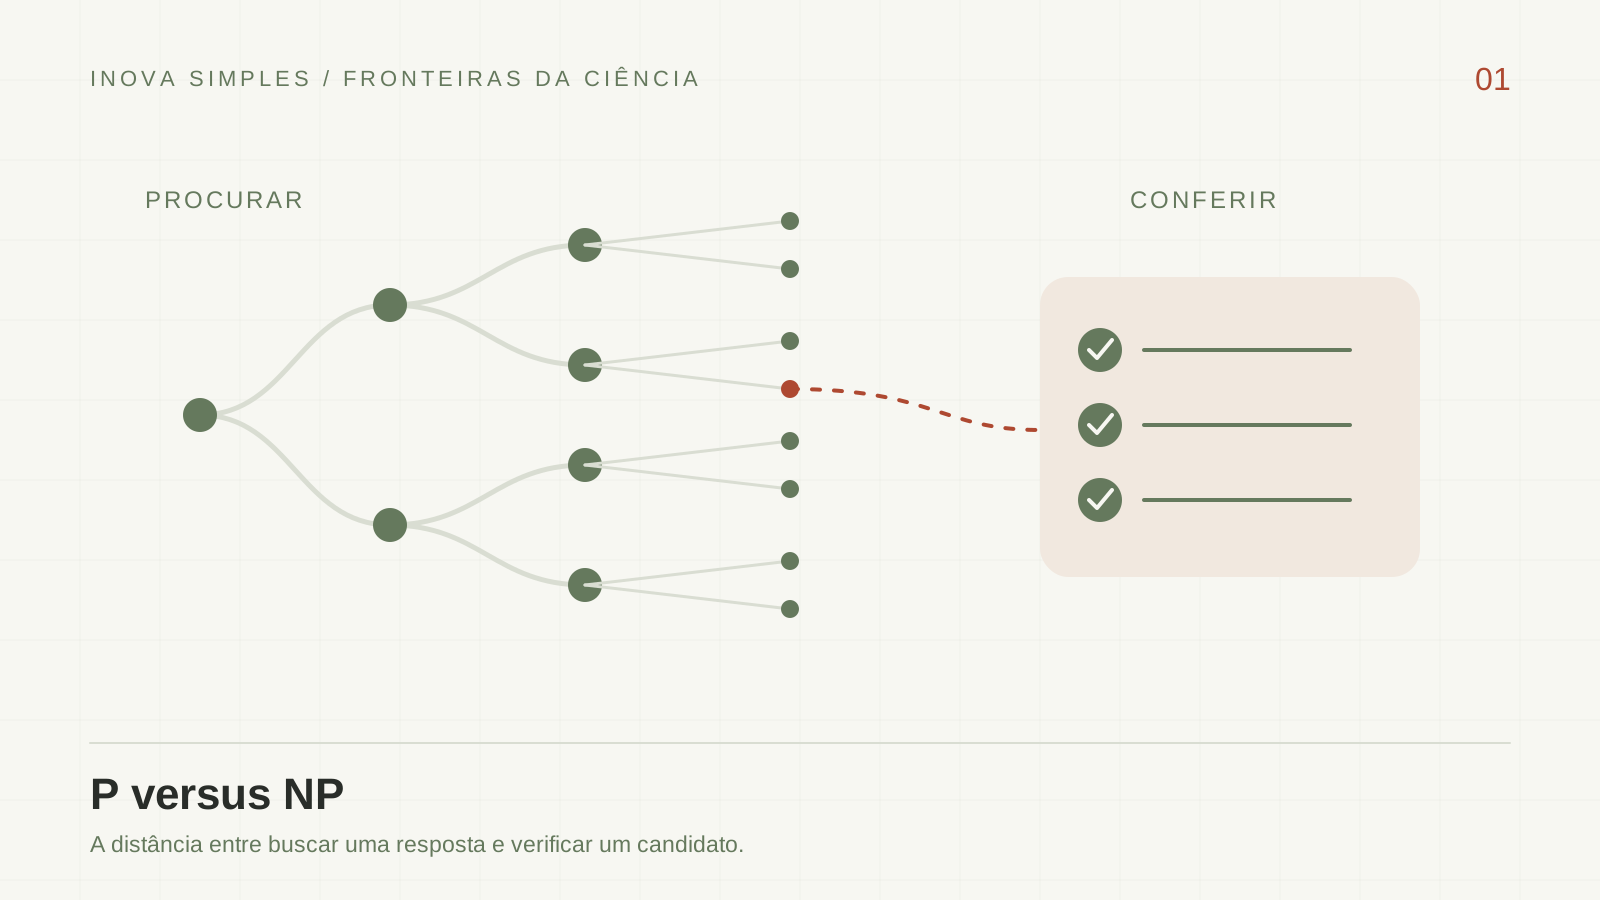
Você precisa montar a escala de uma equipe. Cada pessoa tem horários disponíveis, algumas funções exigem qualificações específicas e ninguém pode estar em dois lugares ao mesmo tempo. Uma colega entrega uma proposta. Conferir cada turno e cada restrição parece trabalhoso, mas é direto. Encontrar uma escala válida do zero pode exigir experimentar combinações demais. Essa diferença entre procurar e conferir está no coração de P versus NP.
P reúne problemas de decisão — perguntas com resposta sim ou não — que possuem um algoritmo com tempo de execução limitado por um polinômio no tamanho dos dados. Exemplos de crescimento polinomial incluem n² e n³. A letra n representa a quantidade de informação necessária para descrever a entrada.
NP reúne problemas em que, quando a resposta é sim, existe um certificado de tamanho polinomial que um algoritmo consegue verificar em tempo polinomial. Uma escala válida pode funcionar como certificado para a pergunta “existe uma escala que cumpra estas regras?”. NP significa tempo polinomial não determinístico; não significa “não polinomial”.
Já sabemos que P está contido em NP: se conseguimos resolver a pergunta com essa eficiência, conseguimos verificar uma resposta positiva. O que ninguém demonstrou é se essa inclusão é estrita. P = NP significaria que as duas classes coincidem. P ≠ NP significaria que pelo menos um problema verificável dessa maneira não tem algoritmo de decisão em tempo polinomial.
Na escala da equipe, fracassar depois de muitas tentativas diz algo sobre o método usado. Não demonstra que qualquer método possível fracassaria. Talvez exista uma maneira de agrupar escolhas, explorar uma estrutura ou evitar uma busca que parecia inevitável. Uma prova de P ≠ NP precisaria excluir todos os algoritmos polinomiais possíveis, incluindo os que ninguém inventou.
Também não basta mostrar que um programa resolve rapidamente centenas de exemplos. Ele pode encontrar respostas em situações favoráveis e levar um tempo enorme nas outras. As classes P e NP consideram um limite de crescimento no pior caso. Um teste de desempenho de um aplicativo responde a uma pergunta diferente da classificação matemática.
Stephen Cook publicou, em 1971, “The Complexity of Theorem-Proving Procedures”. O trabalho mostrou como traduzir problemas verificáveis em tempo polinomial para uma questão sobre fórmulas lógicas. Leonid Levin desenvolveu uma abordagem independente, publicada em 1973. A conexão ficou conhecida como teorema de Cook–Levin.
Richard Karp, em 1972, mostrou que muitos outros problemas combinatórios compartilhavam essa dificuldade. São os problemas NP-completos: pertencem a NP e recebem traduções eficientes de todos os problemas dessa classe. Descobrir um algoritmo polinomial para um deles permitiria decidir todos os problemas de NP em tempo polinomial.
Um solucionador pode combinar busca, simplificações e escolhas inteligentes para lidar com instâncias grandes. Isso tem valor comercial e científico mesmo sem resolver P versus NP. A classificação não diz que toda entrada de um problema difícil será difícil: algumas têm estruturas que permitem respostas rápidas.
Como explica o pesquisador Scott Aaronson, a área também identifica barreiras a famílias de técnicas de demonstração. Saber que um caminho não consegue distinguir as classes ajuda a procurar outro. Esses resultados não provam P = NP nem P ≠ NP; explicam parte da resistência do problema.
Se P = NP vier acompanhado de algoritmos utilizáveis, versões verificáveis de problemas de logística, desenho de circuitos, planejamento e pesquisa de estruturas poderão ganhar métodos muito mais eficientes. A promessa depende da formulação: nem toda tarefa chamada “inteligência” possui um certificado curto, e uma descrição matemática pode deixar de fora aspectos essenciais do mundo real.
Se P ≠ NP, teríamos uma fronteira demonstrada para a computação eficiente no pior caso. Isso daria fundamento a uma estratégia que já funciona na prática: procurar aproximações, explorar casos especiais ou aceitar mais tempo de processamento. A prova não tornaria essas soluções inúteis nem diria qual será o tempo de cada programa.
P = NP comprometeria os fundamentos de mecanismos cuja segurança computacional depende de encontrar certas respostas ser difícil. Porém, transformar essa conclusão em um ataque viável exige um algoritmo adequado e recursos suficientes. Não seria responsável anunciar que todas as senhas cairiam no dia de publicação de uma prova.
A direção contrária também exige cuidado. P ≠ NP, sozinho, não provaria que um sistema específico é seguro. Criptografia precisa de dificuldade nas instâncias usadas, e não apenas de uma entrada ruim em algum problema. Falhas de implementação e vazamentos continuariam existindo.
P versus NP transforma uma experiência familiar — conferir pode ser mais fácil do que criar — em uma pergunta exata sobre algoritmos. Seu valor está em esclarecer quais dificuldades vêm de nossas ferramentas e quais pertencem à própria tarefa. Para uma empresa, um avanço relevante será um método demonstrado, com custos conhecidos e resultados reproduzíveis; uma manchete sobre computadores “capazes de tudo” não substitui isso.
Problemas do MilênioCiênciaMatemáticaComputaçãoAlgoritmosCriptografia
Tecnologia
Tecnologia
Tecnologia
Tecnologia